Game Chiến Thuật Online
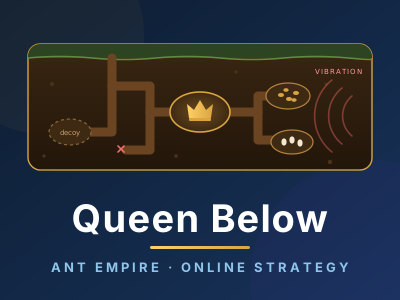
Queen Below: Ant Empire
Cai trị đế chế dưới lòng đất, nơi thông tin là vũ khí
- Unity 6
- C# / .NET
- Nakama
- Blender
Siêu anh hùng gọi, bé sẽ nghe lời
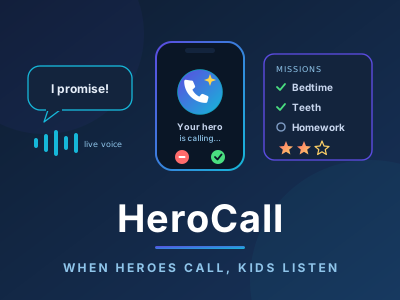
Bố mẹ hẹn giờ để một siêu anh hùng gọi thoại trực tiếp cho con — lúc đi ngủ, đánh răng, làm bài tập hay dọn đồ chơi. Siêu anh hùng trò chuyện với bé, nhận lời hứa, ăn mừng khi bé làm được và nhớ bé cho lần gọi sau. Ứng dụng Flutter đang phát triển, hỗ trợ 12 ngôn ngữ.
Cha mẹ nào cũng quen với những cuộc “thương lượng” mỗi ngày: đi ngủ, đánh răng, làm bài, cất đồ chơi. Cùng một lời nhắc từ cùng một giọng nói, trẻ nghe mãi thành quen tai — nhưng chỉ cần một siêu anh hùng lên tiếng là mắt bé sáng rỡ. Chúng tôi tự hỏi: liệu siêu anh hùng có thể gọi cho bé thật không — một cuộc trò chuyện hai chiều, khích lệ thay vì giảng giải, và đủ an toàn để bố mẹ yên tâm trao điện thoại cho con?
HeroCall cho phép bố mẹ hẹn lịch để một siêu anh hùng gọi thoại trực tiếp cho con. Siêu anh hùng nói chuyện với bé về nhiệm vụ, nhận lời hứa, ăn mừng khi bé giữ lời và nhớ bé trong lần gọi tiếp theo. Dàn nhân vật gồm 20 siêu anh hùng nguyên bản của HeroCall; năm nhân vật cổ tích và truyền thuyết — Ông già Noel, Bà chúa Tuyết, Tôn Ngộ Không, Tiên Răng và Starsong; cùng những siêu anh hùng riêng mà mỗi gia đình tự tạo trong Hero Studio.
Mỗi cuộc gọi chạy qua một pipeline giọng nói dạng streaming: Whisper chuyển lời bé thành chữ, một agent siêu anh hùng xây trên Google ADK quyết định nói gì, rồi giọng TTS có diễn xuất riêng của từng nhân vật trả lời — phát theo từng câu để cuộc trò chuyện liền mạch như gọi thật. Sau cuộc gọi, agent Memory Keeper cập nhật bộ nhớ về bé: sở thích, nếp sinh hoạt, những lần bé làm tốt. An toàn được thiết kế ngay từ đầu: cổng đồng ý của phụ huynh, nhận diện rủi ro an toàn trẻ em trên nhiều ngôn ngữ, kiểm tra từng câu của siêu anh hùng trước khi nói ra, và không lưu lại âm thanh.
HeroCall đang trong giai đoạn phát triển. Pipeline giọng nói, nhiệm vụ, bộ nhớ và lớp an toàn đều phục vụ một nguyên tắc: bé chỉ được nghe những gì một phụ huynh cẩn thận sẽ đồng ý. Đây đúng là kiểu sản phẩm giọng nói thời gian thực, đa agent mà ISEMI xây dựng — giọng nói stream hai chiều, agent biết ghi nhớ, và khâu kiểm tra an toàn chạy trước khi từng câu đến tai người nghe.
Cai trị đế chế dưới lòng đất, nơi thông tin là vũ khí

AI agent điều phối sprint ngay trong Google Chat