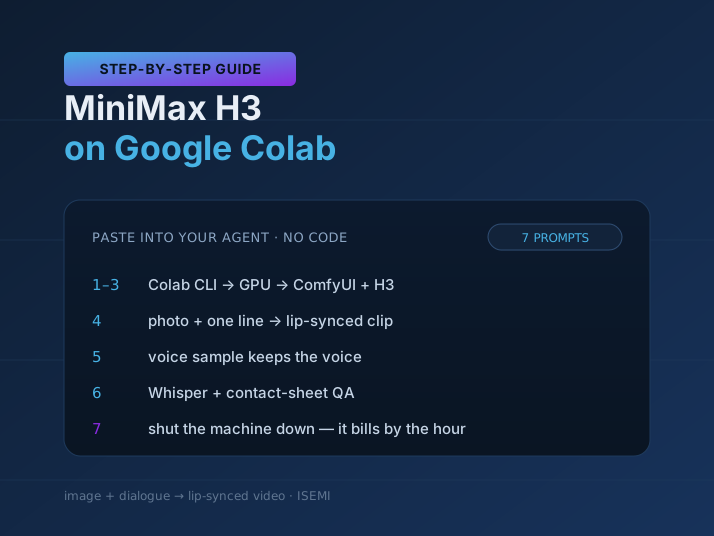
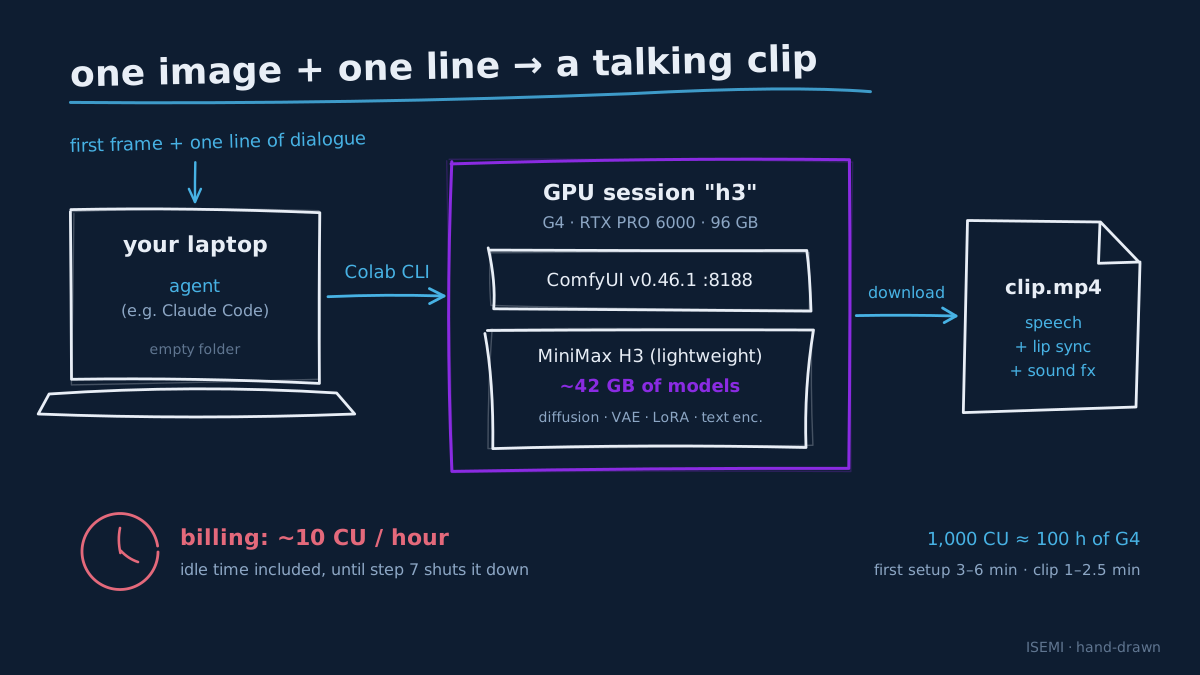
Bạn cần một clip ngắn: nhân vật nói đúng một câu thoại, khớp môi, có tiếng động nền, trong khi trong tay chỉ có một tấm ảnh. MiniMax H3 làm được đúng việc đó: đưa cho nó ảnh khung đầu và một câu thoại, nó dựng hình và tiếng cùng lúc. Vướng mắc nằm ở phần cứng. Ngay cả bản nhẹ cũng chiếm khoảng 42 GB model và cần GPU cỡ trung tâm dữ liệu, thứ mà ít ai có sẵn ở nhà.
Google Colab cho thuê loại máy đó theo giờ. Bài này hướng dẫn chạy MiniMax H3 trên Colab mà bạn không phải viết dòng code nào. Mỗi bước có sẵn một prompt. Bạn dán prompt đó cho agent lập trình chạy trên máy mình (ví dụ Claude Code), agent tự cài đặt, chạy và báo kết quả. Thời gian và kết quả đo bên dưới lấy từ chính các lần team mình chạy đúng quy trình này.
Cần chuẩn bị gì
| Thứ cần có | Ghi chú |
|---|---|
| Tài khoản Google có compute units (CU) của Colab | Google AI Pro có 500 CU, Google AI Ultra x5 có 1.000 CU, Google AI Ultra x20 có 2.000 CU (gói Colab Pro/Pro+ cũng có CU). Xem số dư ở colab.research.google.com, mục Usage. |
| Máy Mac hoặc Linux đã cài agent (ví dụ Claude Code) | Agent sẽ tự cài thêm công cụ dòng lệnh của Colab. |
| Ảnh khung đầu của cảnh | Ảnh dọc 9:16 rõ mặt, hoặc ảnh ngang 16:9. |
| (Tuỳ chọn) File giọng mẫu cho từng nhân vật | Một đoạn .wav dài 8–10 giây, nói rõ, đúng giọng vai. Dùng ở bước 5 để giữ giọng đồng nhất. |
Chi phí và thời gian, đo trên máy G4 (RTX PRO 6000, 96 GB):
| Hạng mục | Con số |
|---|---|
| Thuê máy | ~10 CU mỗi giờ, tính cả lúc máy chờ |
| Lần cài đầu | 3–6 phút |
| Clip thường, 6–8 giây | 1–2,5 phút |
| Clip dùng giọng mẫu, 6,6 giây | ~4,5 phút |
Số CU của mỗi gói làm ra được bao nhiêu clip, tính theo ~10 CU mỗi giờ máy G4:
| Gói | Giờ máy G4 | Clip thường, 6–8 giây | Clip dùng giọng mẫu |
|---|---|---|---|
| Google AI Pro (500 CU) | ~50 giờ | ~1.200–3.000 | ~660 |
| Google AI Ultra x5 (1.000 CU) | ~100 giờ | ~2.400–6.000 | ~1.330 |
| Google AI Ultra x20 (2.000 CU) | ~200 giờ | ~4.800–12.000 | ~2.660 |
Đây là mức trần, chỉ tính thời gian render. Thời gian cài máy (3–6 phút mỗi lần bật máy mới), lúc máy chờ, các lần quay lại với seed khác và bước kiểm tra clip đều trừ vào cùng số dư, nên số clip thực tế sẽ thấp hơn.
Cách dùng hướng dẫn này
- Mở agent trong một thư mục làm việc trống.
- Dán từng prompt theo thứ tự. Chờ agent báo xong và kết quả đúng như dòng "Kết quả đúng" rồi mới sang bước tiếp.
- Nếu agent báo lỗi, dán nguyên lỗi lại cho chính agent đó và nhờ sửa. Phần lớn lỗi đã có cách xử lý trong mục "Lỗi hay gặp" ở cuối bài.
- Xong việc phải tắt máy (bước 7). Máy GPU tính tiền theo giờ bật, kể cả lúc không làm gì.
Phần trong ngoặc vuông của mỗi prompt là chỗ bạn tự điền.
Bước 1–3: cài công cụ, thuê GPU, cài MiniMax H3
Bước 1: cài Colab CLI và đăng nhập
Cài công cụ dòng lệnh chính thức của Google Colab (github.com/googlecolab/google-colab-cli, gói "google-colab-cli") bằng uv tool, rồi chạy lệnh đăng nhập. Khi CLI in ra đường link đăng nhập, đưa link đó cho tôi để tôi mở trình duyệt và dán mã xác nhận lại. Sau khi đăng nhập, chạy lệnh xem số dư compute units và báo cho tôi con số.
Kết quả đúng: agent báo số dư, ví dụ "Current balance: 1000.00 compute units".
Bước 2: thuê một máy GPU
Dùng Colab CLI tạo một phiên máy GPU tên "h3". Thử loại G4 trước; nếu Colab báo hết máy (Service Unavailable) thì thử H100. TRƯỚC khi tạo, kiểm tra xem đã có phiên tên "h3" chưa — nếu đã có thì dùng lại, tuyệt đối không tạo trùng tên (tạo trùng sẽ bỏ rơi máy cũ mà máy cũ vẫn tính tiền). Lưu ý: lệnh của CLI luôn trả mã thoát 0 kể cả khi lỗi, nên hãy đọc nội dung in ra để biết thành công hay không. Báo tôi loại GPU đã thuê được.
Kết quả đúng: "Session READY" và tên GPU, ví dụ G4.
Bước 3: cài ComfyUI và tải model H3 bản nhẹ
Trên phiên Colab "h3", chuẩn bị máy để chạy MiniMax H3 bản nhẹ bằng ComfyUI:
1. Cài ComfyUI đúng tag v0.46.1 (bản này có sẵn các node MiniMax H3) và cài thư viện của nó.
2. Tải từ Hugging Face repo "Comfy-Org/MiniMax-H3" vào đúng thư mục models của ComfyUI các file:
   - diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors
   - vae/minimax_h3_video_vae_int8_convrot.safetensors
   - vae/minimax_h3_audio_vae_fp32.safetensors
   - loras/minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors
   - text encoder chọn theo GPU: nếu GPU là Blackwell (G4, compute capability từ 10 trở lên) thì text_encoders/qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors; nếu là H100 hoặc đời cũ hơn thì text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors.
3. Khởi động server ComfyUI ở cổng 8188, chạy tách hẳn khỏi cell (tiến trình riêng, không giữ cell mở), rồi chờ tới khi server trả lời.
Trong lúc cài và tải (mất vài phút), cứ khoảng 20 giây in một dòng tiến độ — Colab CLI sẽ cắt một cell im lặng quá lâu. Kết thúc bằng một dòng rõ ràng "READY" kèm tên GPU và text encoder đã dùng, hoặc "ERROR" kèm lý do. Làm sao để chạy lại bước này lần nữa không tải lại những gì đã có.
Kết quả đúng: dòng READY, khoảng 42 GB model đã nằm trên máy.
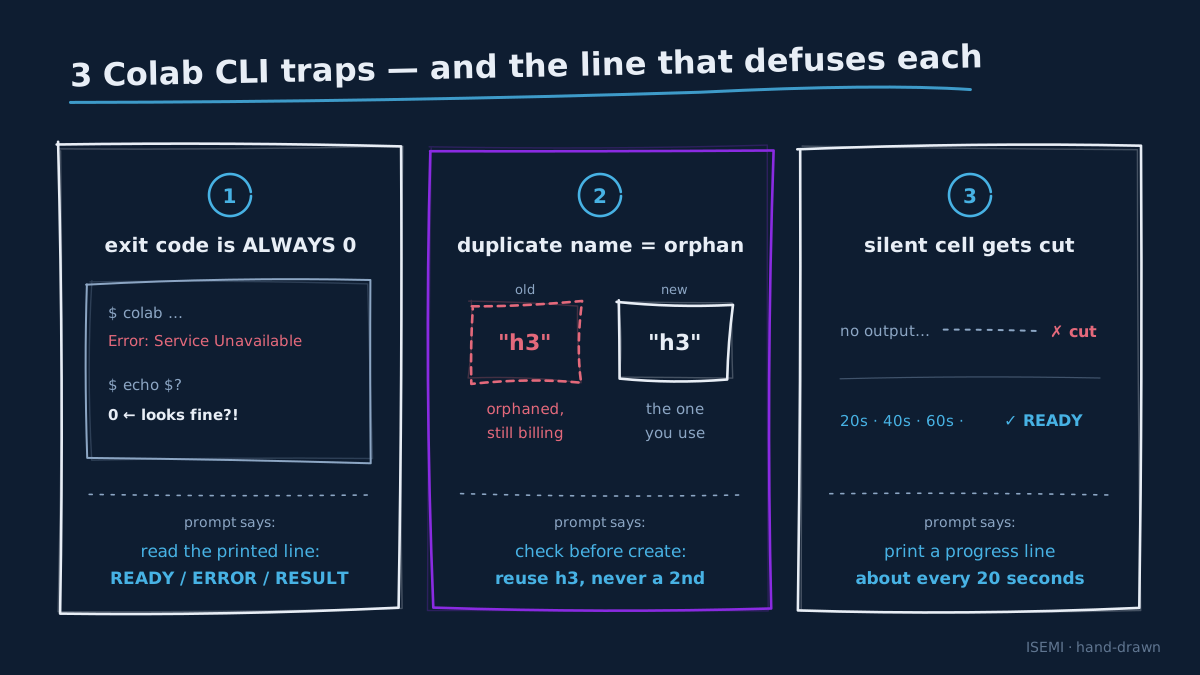
Vài câu trong ba prompt trên trông có vẻ cầu kỳ, nhưng câu nào cũng có lý do: bỏ đi là gặp chuyện thật. Colab CLI luôn thoát với mã 0 dù chạy được hay không, nên agent nào tin mã thoát sẽ vui vẻ báo "thành công" cho một lần chạy hỏng. Tạo phiên thứ hai trùng tên không thay thế phiên cũ, mà bỏ rơi nó, và máy bị bỏ rơi vẫn tính tiền. Cell im lặng quá lâu thì bị cắt ngang giữa lúc tải. Ba prompt đã lo sẵn cả ba chuyện này.
Bước 4: tạo video từ ảnh và lời thoại
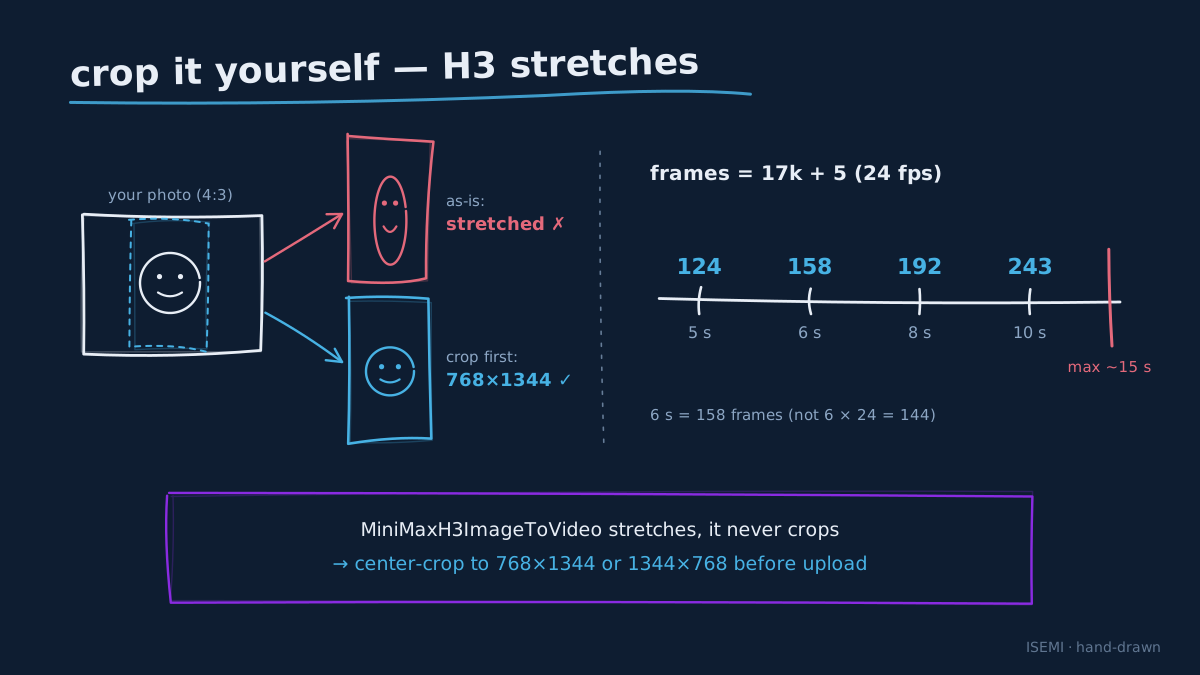
Đây là lúc H3 thể hiện: một tấm ảnh cộng một câu thoại thành clip có tiếng nói khớp môi và tiếng động. Có hai chi tiết quan trọng hơn cả. Thứ nhất, tự cắt ảnh trước. Node image-to-video của H3 kéo giãn ảnh cho vừa khung, nên ảnh sai tỉ lệ sẽ ra hình méo. Thứ hai, độ dài clip tính bằng số khung trên một lưới cố định. H3 chạy 24 khung/giây và số khung phải bằng 17k+5:
| Độ dài clip | Số khung |
|---|---|
| 5 giây | 124 |
| 6 giây | 158 |
| 8 giây | 192 |
| 10 giây | 243 |
Tối đa khoảng 15 giây. Câu thoại đặt trong thẻ riêng của H3: <d>[Vietnamese] câu thoại</d>.
Tạo một clip MiniMax H3 image-to-video trên phiên "h3", theo workflow mẫu chính thức "video_minimax_h3_i2v" của Comfy-Org (repo workflow_templates), gửi qua API của ComfyUI:
- Ảnh khung đầu: [đường dẫn ảnh trên máy tôi]. Trước khi tải lên, cắt giữa ảnh cho đúng tỉ lệ rồi thu về 768×1344 (dọc) hoặc 1344×768 (ngang), vì node MiniMaxH3ImageToVideo sẽ KÉO GIÃN ảnh chứ không cắt.
- Độ dài: [6] giây. H3 chạy 24 khung/giây và số khung phải nằm trên lưới 17k+5: 5 giây = 124 khung, 6 giây = 158, 8 giây = 192, 10 giây = 243, tối đa khoảng 15 giây.
- Dùng LoRA turbo 8 bước, sampler res_multistep, seed ngẫu nhiên.
- Prompt: [mô tả cảnh, người, hành động, máy quay theo từng mốc giây]. Câu thoại đặt ngay trong nhịp hành động bằng cú pháp của H3: <d>[Vietnamese] câu thoại</d> — ví dụ "1–3.5s: cô ấy nhìn thẳng và nói đúng một lần: <d>[Vietnamese] Tôi về rồi.</d>". Viết rõ giọng nói (giới tính, tuổi, giọng Bắc/Nam, trầm/trong) và "không ai nói thêm gì khác".
- KHÔNG viết kiểu "IMPORTANT — X nói CHÍNH XÁC câu…": H3 sẽ đọc luôn cả tên người và từ thừa.
Chờ render xong, tải file mp4 về thư mục hiện tại và báo: thời lượng, kích thước, có tiếng hay không, thời gian render.
Kết quả đúng: một file mp4 dài đúng như đặt, có tiếng nói khớp môi và tiếng động. Muốn quay cảnh khác thì sửa phần trong ngoặc vuông rồi gửi lại prompt.
Bước 5: giữ giọng nhân vật đồng nhất bằng file giọng mẫu (Ref2VA)
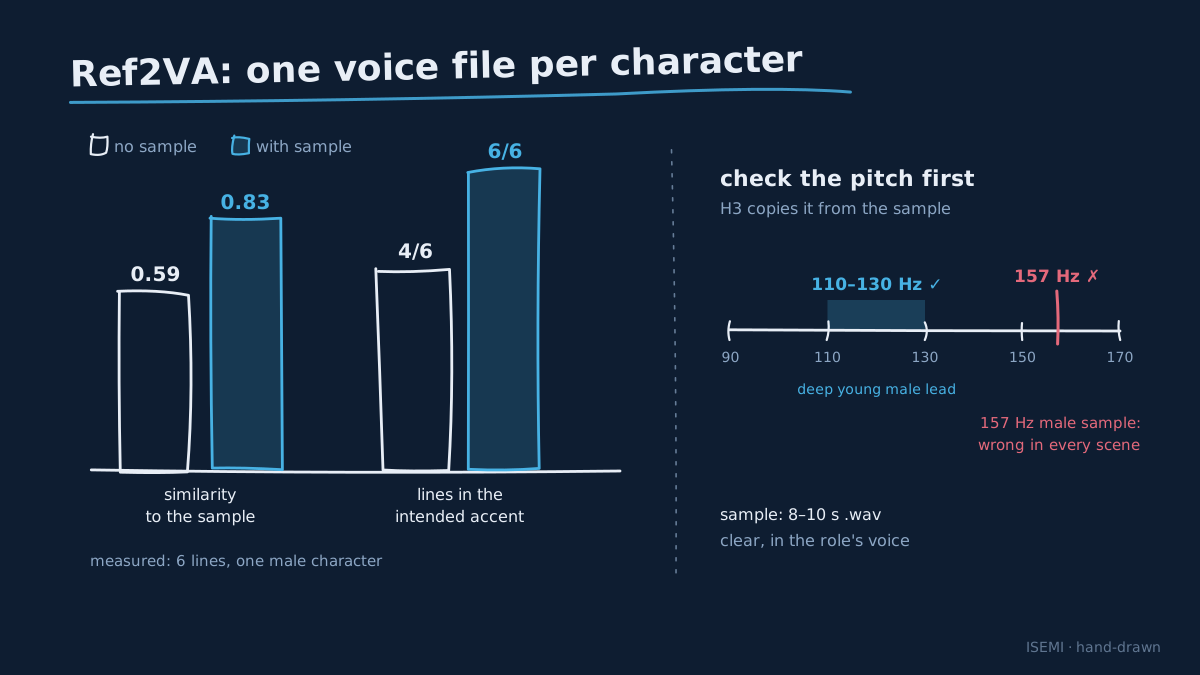
Ở bước 4, H3 tự nghĩ ra giọng cho mỗi clip, nên cùng một nhân vật có thể nghe như nhiều người khác nhau. Chế độ Ref2VA cho H3 nghe trước một file giọng mẫu của nhân vật, rồi nói câu thoại bằng chất giọng đó.
Kết quả đo thực tế trên 6 câu thoại của một nhân vật nam:
| Chỉ số | Không giọng mẫu | Có giọng mẫu |
|---|---|---|
| Độ giống giọng mẫu | 0,59 | 0,83 |
| Số câu ra đúng giọng Bắc | 4/6 | 6/6 |
Chọn file giọng mẫu cho kỹ. H3 chép cả cao độ của giọng mẫu. Nhờ agent đo cao độ trung bình trước khi dùng: nam chính trẻ, giọng trầm thường ở khoảng 110–130 Hz. Một giọng mẫu nam 157 Hz đã ra nghe ẻo lả ở mọi cảnh.
Trên phiên "h3", thêm chế độ Ref2VA của MiniMax H3:
1. Tải thêm từ "Comfy-Org/MiniMax-H3": diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors và loras/minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors.
2. Dựng đồ thị theo mẫu "video_minimax_h3_r2v" và "video_minimax_h3_multiframe_reference" của Comfy-Org: node MiniMaxH3ReferenceToVideo nhận file giọng mẫu [đường dẫn .wav] làm ref_audio đầu tiên (<Audio 1>); ảnh khung đầu (đã cắt 768×1344 như bước 4) đưa vào MiniMaxH3AddGuide ở frame 0 (<Picture 1>). Latent cho sampler lấy từ MiniMaxH3ReferenceToVideo, AddGuide chỉ thêm vào conditioning. Dùng LoRA ref2v ở 20 bước, scheduler "beta".
3. Viết prompt theo đúng cấu trúc trong tài liệu chính thức của MiniMax (huggingface.co/MiniMaxAI/MiniMax-H3, file docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md), gồm 6 mục theo thứ tự: subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape, non_diegetic_music. Bắt buộc có:
   - "<Subject 1> is [tên + ngoại hình người nói] in <Picture 1>." và "<Audio 1> is the voice-timbre reference for <Subject 1> (S1)."
   - Trong detailed_description: "<Subject 1> (S1) says exactly once, in the voice timbre referenced from <Audio 1>: <d>[Vietnamese] câu thoại</d>"
   - Câu khoá: video bắt đầu đúng từ <Picture 1>, chỉ có những người đã có trong <Picture 1>, không ai đi vào, không ai bị nhân đôi, máy quay chỉ chuyển động khi cảnh yêu cầu.
4. Render [6] giây như bước 4, tải mp4 về và báo thời gian render.
Kết quả đúng: clip khớp môi, giọng nghe giống file mẫu. Mỗi nhân vật luôn dùng đúng file giọng của mình. Cảnh không có thoại thì quay như bước 4.
Bước 6–7: kiểm tra clip, rồi tắt máy
Bước 6: kiểm tra clip
Kiểm tra các file mp4 vừa tải về: thời lượng có đúng không, có tiếng không. Chép lời phần tiếng nói (dùng Whisper, ngôn ngữ tiếng Việt) và so với câu thoại tôi đã viết: câu có được nói đủ, đúng MỘT lần, không thừa chữ không? Làm một ảnh ghép khung hình mỗi giây một ô để tôi xem nhanh máy quay có lia lệch hay có người lạ xuất hiện không. Báo kết quả từng clip thành bảng.
Bước 7: tắt máy (bắt buộc)
Tắt phiên Colab "h3", sau đó liệt kê mọi phiên còn chạy để chắc chắn không còn máy nào bật, rồi báo số dư compute units hiện tại.
Kết quả đúng: "Session terminated", không còn phiên nào đang chạy, và số dư không còn tiếp tục giảm.
Lỗi hay gặp
| Hiện tượng | Nguyên nhân và cách xử lý |
|---|---|
| Agent báo "thành công" nhưng không có file | Colab CLI luôn trả mã 0, kể cả khi lỗi. Nhờ agent luôn in dòng READY/ERROR/RESULT rõ ràng và dựa vào đó để kết luận. |
| Số dư tụt nhanh bất thường | Có thể đã tạo trùng tên phiên, máy cũ vẫn chạy. Nhờ agent liệt kê và tắt hết các phiên thừa. |
| Cell bị cắt giữa chừng khi cài hoặc tải | Cell im lặng quá lâu. Nhắc agent in dòng tiến độ khoảng 20 giây một lần. |
| Cell treo mãi khi khởi động ComfyUI | Server phải chạy tách hẳn thành tiến trình riêng, không chạy kèm trong cell. |
| G4 báo hết máy | Thuê H100, dùng text encoder INT8 (bản NVFP4 chỉ chạy trên Blackwell). |
| Không thuê thêm được máy thứ 4 | Gói Colab giới hạn khoảng 3 GPU chạy cùng lúc. |
| Nhân vật đọc cả tên mình hoặc nói câu hai lần | Chỉ dùng thẻ <d>[Vietnamese] …</d> và ghi "nói đúng một lần". Clip dài hơn câu thoại nhiều thì ghi rõ "sau đó im lặng, môi khép". |
| Giọng lệch vùng miền giữa các clip | Ghi rõ giọng trong prompt; tốt nhất dùng giọng mẫu (bước 5). |
| Người lạ xuất hiện, nhân vật bị nhân đôi, máy lia lung tung | Thêm câu khoá ở bước 5. Cảnh tĩnh thì ghi "máy đứng yên". Quay lại với seed khác. |
| Ảnh bị méo | Chưa cắt đúng tỉ lệ trước khi tải lên. Xem bước 4. |
| Quên tắt máy | Máy vẫn tính tiền. Luôn chạy bước 7, hoặc nhờ agent tự tắt máy sau 10 phút không dùng. |
Câu hỏi thường gặp
Chạy MiniMax H3 trên Google Colab tốn bao nhiêu?
Máy G4 tốn khoảng 10 compute units mỗi giờ, và đồng hồ vẫn chạy cả lúc máy chờ. 500 CU của gói Google AI Pro tương đương khoảng 50 giờ máy G4: nếu chỉ tính thời gian render, đủ cho khoảng 1.200–3.000 clip thường 6–8 giây, hoặc khoảng 660 clip dùng giọng mẫu. Gói Ultra x5 (1.000 CU) và Ultra x20 (2.000 CU) lần lượt gấp đôi và gấp bốn con số đó. Thời gian cài máy, lúc máy chờ và các lần quay lại làm số thực tế thấp hơn, còn rủi ro chi phí lớn nhất là quên tắt máy sau khi xong việc, vì vậy bước 7 là bắt buộc.
Có cần biết lập trình không?
Không. Mỗi bước là một prompt cho agent lập trình như Claude Code. Agent tự cài công cụ, tự viết lệnh gọi API của ComfyUI và báo kết quả. Phần của bạn là đăng nhập Colab trên trình duyệt và đối chiếu từng kết quả với dòng "Kết quả đúng".
Chạy MiniMax H3 trên H100 thay vì G4 được không?
Được. Dùng text encoder INT8 (qwen3vl_32b_minimax_h3_int8_convrot), vì bản NVFP4 chỉ chạy trên GPU Blackwell như G4. Prompt ở bước 2 đã tự chuyển sang H100 khi hết G4, và bước 3 tự chọn encoder phù hợp.
Clip MiniMax H3 dài tối đa bao lâu?
Khoảng 15 giây. H3 render 24 khung/giây và số khung phải nằm trên lưới 17k+5: 124 khung cho 5 giây, 158 cho 6 giây, 192 cho 8 giây và 243 cho 10 giây.
Vì sao nhân vật nói câu thoại hai lần, hoặc đọc luôn tên mình?
Gần như luôn do prompt. Đặt câu thoại trong thẻ thoại của H3, ghi "nói đúng một lần", và tránh kiểu nhấn mạnh "IMPORTANT — X nói CHÍNH XÁC…", vì H3 hay đọc to luôn những chữ đó. Clip dài hơn câu thoại nhiều thì thêm "sau đó im lặng, môi khép".
Làm sao giữ cùng một giọng qua nhiều clip?
Dùng chế độ Ref2VA (bước 5) với file giọng mẫu 8–10 giây cho từng nhân vật. Trong lần thử 6 câu của team mình, độ giống giọng mẫu tăng từ 0,59 lên 0,83, và cả 6 câu đều ra đúng giọng Bắc. Nhớ đo cao độ giọng mẫu trước, vì H3 chép cả cao độ.
Từ một clip đến cả pipeline
Làm từng clip một là cách đúng để nắm các tính khí của H3. Khi cần hàng chục cảnh với cùng nhân vật và cùng giọng, các prompt trên sẽ thành một pipeline: danh sách cảnh, mỗi nhân vật một file giọng, tự kiểm tra từng lần render, và máy tự tắt khi xong. Đó là loại hệ thống team mình xây. Xem dịch vụ tạo video và hình ảnh bằng AI của ISEMI, hoặc đọc cách team mình chạy cả một pipeline video từ agent bằng Claude Code skills.
Tài liệu gốc: Comfy-Org/MiniMax-H3 trên Hugging Face · Hướng dẫn viết prompt Ref2VA của MiniMax · Workflow mẫu của ComfyUI